03.维度建模入门:星型模型 vs 雪花模型 vs 星座模型
一、前言
1.1 逻辑二维表
数据仓库中,数据以表的形式存在,形式如下:
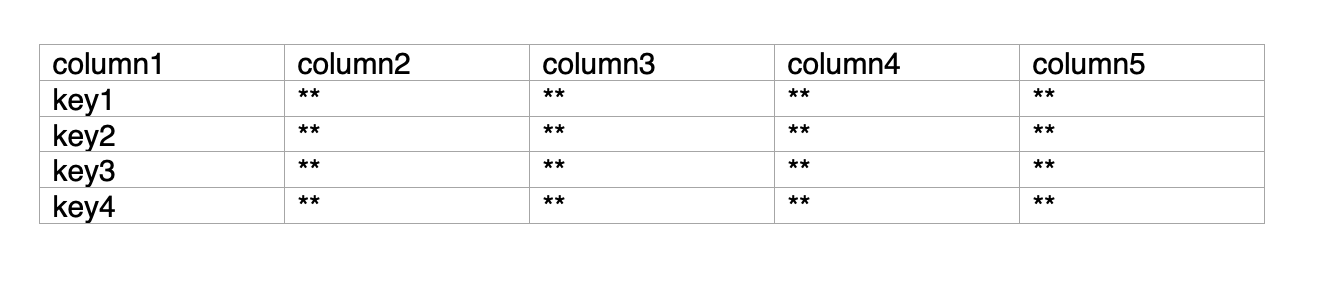
称为“逻辑表”,主要原因是在实际存储的时候,不一定是按照我们看到的形式存储的,会有各种形式的存储优化(例如列存)。 但是在建模的时候,二维表是我们思考的基本单位。
数据仓库建模就是 定义这些表的内部结构和表之间的关联关系。 一张表属于什么表,取决于其存储的内容,而不是其表名。表名只是方便我们识别和管理,而不是决定表的类型。
重要的事情再讲一遍: 无论是 维度表、事实表、桥接表、宽表、竖表、全量表、增量表、拉链表,我们都是在讲其存储的内容,内容的组织形式,而不是表的名字,表的名字是为了方便方便识别和管理。
1.2 星型模型、雪花模型、星座模型 在讲什么
- 这三种模型属于维度建模方法,不是独立的建模方法论;
- 这三种模型描述的是二维表的关联形态,其描述的很形象,表关联起来的图形像什么就叫什么模型。(思考:三种模型描述了表关联形式,但是表为什么要关联、表什么时候关联?)
- 表内部结构决定了关联形态,关联形态决定了如何设计表内部结构。
二、先理解维度建模的两类表
讲模型之前,必须先分清维度建模里的两类表,分别是事实表和维度表。
| 表类型 | 存什么 | 特点 | 举例 |
|---|---|---|---|
| 事实表 (Fact) | 业务过程产生的可度量数值 | 行数巨大、持续增长、窄而长 | 订单金额、下单数量 |
| 维度表 (Dimension) | 描述业务事件的上下文属性 | 行数少、相对稳定、宽而短 | 用户、商品、时间、地区 |
事实表回答「发生了什么,量是多少」,维度表回答「发生在谁身上、什么时候、什么渠道」。两者通过外键关联:事实表里存一堆维度表的主键,查询时 JOIN 起来。
              ┌──────────────┐
              │   dim_user   │  ← 维度表(谁)
              │  user_id(PK) │
              │  user_name   │
              └──────┬───────┘
                     │ user_id
              ┌──────▼───────┐
              │  fact_order  │  ← 事实表(发生了什么)
              │  order_id    │
              │  user_id(FK) │
              │  product_id  │
              │  amount      │  ← 度量(可加)
              └──────┬───────┘
                     │ product_id
              ┌──────▼───────┐
              │ dim_product  │  ← 维度表(什么)
              │ product_id   │
              │ category     │
              └──────────────┘
二、星型模型 (Star Schema)
2.1 长什么样
星型模型是最经典、最常用的维度模型。它的结构是:一张事实表居中,周围一圈维度表直接连上来,没有中间层,形似星星。
                dim_date
                    │
   dim_user ──── fact_order ──── dim_product
                    │
                dim_region
特征:
- 一张事实表 + N 张维度表,全部通过外键直接关联
- 维度表之间不互相连接
- 维度表不规范化(允许冗余),比如
dim_user里同时存city和province,而不是拆成地区维度
2.2 为什么是主流
星型模型被 Kimball 学派捧为「默认选择」,核心就一句话:查询简单、性能好。
- JOIN 少:任何分析都只需事实表 + 少量维度表,最多
N+1张表 JOIN,通常 2-3 张 - SQL 直观:分析师一眼能看懂,不需要理解复杂的规范化层级
- 列存友好:宽维度表在列存引擎下压缩率高、扫描快
-- 星型模型下,查「各城市订单总额」只需 2 张表
SELECT r.province, SUM(f.amount) AS total_amount
FROM fact_order f
JOIN dim_region r ON f.region_id = r.region_id
WHERE f.order_date >= '2026-01-01'
GROUP BY r.province;
2.3 代价
维度表不规范化,意味着冗余。dim_user 里 province 字段在 1000 万用户里重复出现,占存储。不过在现代列存 + 字典编码下,这种冗余的成本几乎可以忽略——这也是星型「赢」了雪花的关键原因之一。
三、雪花模型 (Snowflake Schema)
3.1 长什么样
雪花模型是星型的「规范化版本」:维度表继续往下拆成多级子维度表,形成层级,形似雪花。
                dim_date
                    │
   dim_user ──── fact_order ──── dim_product
      │                            │
  dim_city ── dim_province     dim_category ── dim_brand
比如 dim_user 不再存 city、province,而是只存 city_id,然后 city 又指向 province。维度表被拆到第三范式(3NF)。
3.2 优点
- 消除冗余:地区、分类这类层级信息只存一份
- 维护一致性:改了
dim_province的名字,所有下游自动生效,不会出现「同一省份两种写法」
3.3 为什么实际很少用
雪花模型在理论上「更干净」,但工程上几乎被星型碾压:
| 维度 | 星型 | 雪花 |
|---|---|---|
| JOIN 数量 | 少 | 多(每级子维度多一个 JOIN) |
| 查询性能 | 快 | 慢(JOIN 是数仓最大开销) |
| SQL 复杂度 | 低 | 高(分析师要懂层级) |
| 存储冗余 | 有 | 无 |
| 维护成本 | 中 | 低(规范化) |
关键结论:雪花省下的那点存储,远不够抵消多出来的 JOIN 开销。维度表本身数据量就小(用户维度几千万行在数仓里算「小表」),冗余的代价极低;而 JOIN 是数仓查询的绝对瓶颈。
3.4 雪花模型的少数适用场景
雪花模型并非一无是处,两种情况下可以局部采用:
- 维度层级很深且查询频繁按层级钻取——比如地区有「国家→省→市→区」四级,且 BI 经常要按省、市逐层下钻
- 维度表本身巨大且层级稳定——规范化能明显省存储
但即便用,也通常只在局部雪花化(只有一两个维度拆),而不是全盘雪花。
四、星座模型 (Constellation Schema / 星系模型)
4.1 长什么样
星座模型(也叫星系模型、事实星座)是多张事实表共享维度表的结构,形似多个星型交叠在一起。
             dim_date
            /        \
   dim_user ─ fact_order   fact_payment ─ dim_channel
        \      |                |
         \  dim_product ────────┘
          \      |
           fact_refund ── dim_region
注意:dim_user、dim_date、dim_product 被 fact_order、fact_payment、fact_refund 三张事实表共享。
4.2 为什么需要星座模型
真实数仓从来不是只有一张事实表。电商有订单事实、支付事实、退款事实、浏览事实、加购事实……它们共享同一套维度(用户、时间、商品、地区)。
星座模型解决的核心问题是:让不同业务过程的事实表,共享一致的维度,从而支持跨域分析(比如「各渠道的 GMV」= 订单事实 JOIN 渠道维度 + 支付事实 JOIN 渠道维度)。
4.3 核心:一致性维度 (Conformed Dimension)
星座模型能成立的前提是一致性维度:被共享的维度表,在所有事实表里定义完全一致(相同的字段名、相同的取值域、相同的语义)。
fact_order.user_id    ┐
fact_payment.user_id  ├── 都指向同一张 dim_user,且语义一致
fact_refund.user_id   ┘
如果订单事实里的 user_id 和支付事实里的 user_id 不是同一套编码,JOIN 出来就是笛卡尔积垃圾。
这正是 数据仓库建模原则 里「维度一致才能跨域分析」这条原则的由来。
五、三种模型对比总表
| 维度 | 星型模型 | 雪花模型 | 星座模型 |
|---|---|---|---|
| 事实表数量 | 1 张 | 1 张 | 多张 |
| 维度表是否规范化 | 否(冗余) | 是(3NF 层级) | 取决于维度 |
| JOIN 数量 | 少 | 多 | 中 |
| 查询性能 | 高 | 低 | 高 |
| 存储 | 有冗余 | 省存储 | 有冗余 |
| 适用场景 | 单一业务过程 | 维度层级深的局部 | 企业级多业务过程 |
| 本质 | 基础形态 | 星型的规范化变体 | 多个星型共享维度 |
一句话记忆:
- 星型 = 一张事实表 + 一圈维度
- 雪花 = 星型里维度继续往下拆
- 星座 = 多张事实表共享同一批维度
六、小结
- 星型模型:一张事实表 + 一圈维度,查询快、SQL 简单,是默认选择
- 雪花模型:维度规范化,省存储但 JOIN 多,实际少用,只在局部出现
- 星座模型:多事实表共享一致性维度,企业级多业务过程的必然形态
「数据仓库技术」文章同步更新,不错过每一篇干货
备注「数据仓库技术」加入社群,每日一道大厂SQL真题